Yapay Zeka Botlarına robots.txt ile İzin
Hangi yapay zeka botlarına izin vermeli: OAI-SearchBot, GPTBot, ClaudeBot, PerplexityBot. Kopyalanabilir robots.txt ve Cloudflare kontrolü.
Kısaca
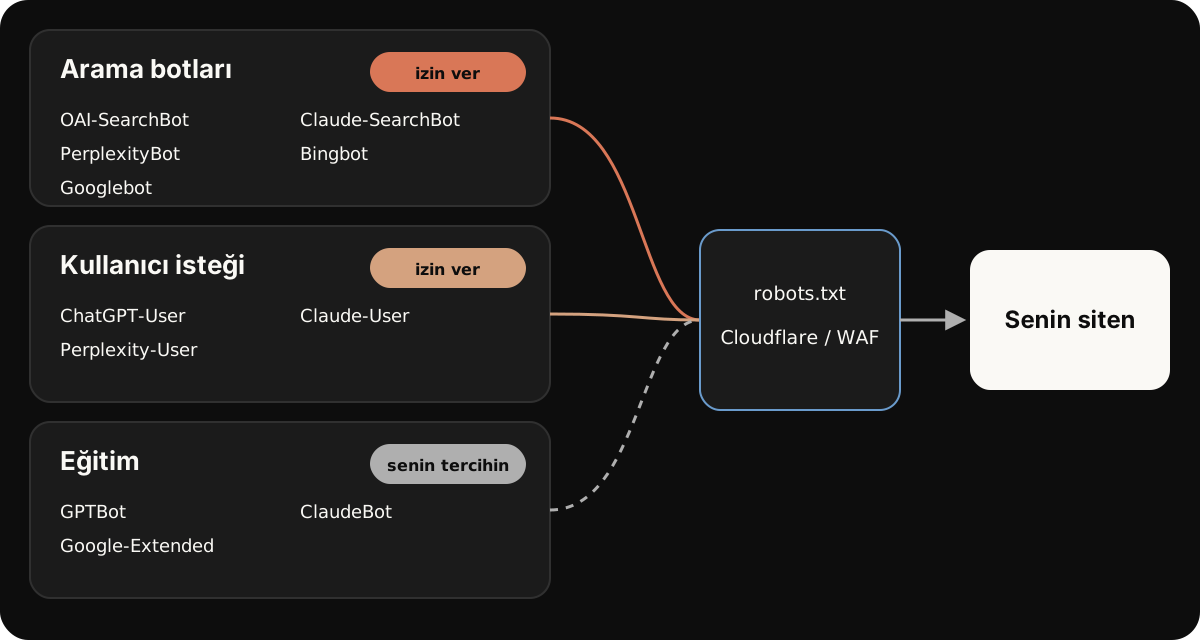
- AI cevaplarında görünüp görünemeyeceğine arama botları karar verir. OAI-SearchBot, Claude-SearchBot, PerplexityBot, Bingbot ve Googlebot'a izin ver.
- Eğitim botları (GPTBot, ClaudeBot, Google-Extended) ayrı bir tercih. Onları engellemek seni aramadan çıkarmaz.
- Cloudflare'i ve WAF'ını kontrol et: robots.txt izin verse bile tarayıcılara 403 dönebilirler.
Üç tür AI botu
AI şirketleri farklı işler için farklı botlar çalıştırır. Hangisinin ne olduğunu bilmek, yanlış olanı engellemeni önler.
| Bot | Şirket | Görevi | Engellersen |
|---|---|---|---|
| OAI-SearchBot | OpenAI | Siteleri ChatGPT aramasında gösterir | ChatGPT arama cevaplarında gösterilmezsin1 |
| ChatGPT-User | OpenAI | Kullanıcı isteyince sayfayı getirir | robots.txt kuralları geçerli olmayabilir1 |
| GPTBot | OpenAI | Eğitim | İçeriğin eğitimde kullanılmaz1 |
| Claude-SearchBot | Anthropic | Arama sonuç kalitesi | Claude arama sonuçlarındaki görünürlüğün azalabilir2 |
| Claude-User | Anthropic | Kullanıcı sorguları için sayfa getirir | Claude sayfanı kullanıcı için getiremez2 |
| ClaudeBot | Anthropic | Eğitim | Gelecekteki içeriğin eğitim dışı kalır2 |
| PerplexityBot | Perplexity | Siteleri Perplexity sonuçlarında gösterir (eğitim değil) | Perplexity’de gösterilmezsin3 |
| Perplexity-User | Perplexity | Kullanıcı istekleri için sayfa getirir | Genelde robots.txt’i yok sayar3 |
| Google-Extended | Gemini eğitimi ve grounding | Google Arama’ya etkisi yok4 |
AI aramasına kapıyı açan bir robots.txt
User-agent: *
Allow: /

User-agent: OAI-SearchBot
User-agent: ChatGPT-User
User-agent: Claude-SearchBot
User-agent: Claude-User
User-agent: PerplexityBot
User-agent: Bingbot
User-agent: Googlebot
Allow: /

Sitemap: https://senin-siten.com/sitemap.xml
Eğitim botlarına (GPTBot, ClaudeBot, Google-Extended) da izin verip vermemek bir iş kararı. Aramada görünüp görünmemeni değiştirmez.
Cloudflare ve güvenlik duvarları
robots.txt işin yarısı. OpenAI, Cloudflare gibi CDN’lerin, WAF’ların, CAPTCHA’ların ve JavaScript kontrollerinin tarayıcılarını 403 ile engelleyebileceği konusunda uyarıyor ve izin verebilmen için arama botunun IP listesini yayınlıyor.5
Cloudflare’de:
- AI trafiği Search, Agent ve Training olarak gruplanır. 15 Eylül 2026’dan beri yeni alan adlarında Training ve Agent botları yalnızca reklam gösteren sayfalarda engelleniyor; Search açık kalıyor.6
- AI Crawl Control hangi AI servislerinin sitene eriştiğini gösterir ve her tarayıcıya izin vermeni ya da engellemeni sağlar. Tüm planlarda var.7
- Yönetilen robots.txt GPTBot, ClaudeBot ve Google-Extended gibi eğitim botlarını engeller; arama botları o listede yok.8
Kurulumdan sonra AI Crawl Control’ü aç; Search kategorisine ve asistanların istek üzerine sayfa getirmesini istiyorsan Agent’a izin verildiğinden emin ol.
JavaScript: gizli engel
Vercel’in tarayıcı verisine göre büyük AI tarayıcılarının çoğu (OAI-SearchBot, ChatGPT-User, GPTBot, ClaudeBot ve PerplexityBot dahil) JavaScript çalıştırmıyor; Gemini ve AppleBot çalıştırıyor.9 Ana metnin ancak JavaScript çalışınca görünüyorsa, birçok AI tarayıcısı boş bir sayfa görür. Önemli içeriği HTML olarak sun.
Peki llms.txt?
llms.txt, Jeremy Howard’ın (2024) önerdiği, yapay zekaya sitenin temiz bir özetini veren bir Markdown dosyası.10 Bir standart değil, öneri. Google, Arama’nın llms.txt dosyalarını yok saydığını söylüyor;11 büyük AI sağlayıcılarından okuduğunu resmi olarak söyleyen yok.
Biz yine de bir tane yayınlıyoruz: onu çeken ajanlar rehberlerimizin temiz bir haritasını alıyor. Eklemesi kolay, ama taranabilir sayfaların ve iyi içeriğin yerini tutmaz. Ayrıntısı: llms.txt nedir, işe yarar mı?
Kaynaklar
-
OpenAI, Overview of OpenAI Crawlers. ↩ ↩2 ↩3
-
Claude Help Center, Does Anthropic crawl data from the web, and how can site owners block the crawler?, Nisan 2026. ↩ ↩2 ↩3
-
Perplexity, Perplexity Crawlers. ↩ ↩2
-
Google, Google’s common crawlers, Ekim 2026. ↩
-
OpenAI Help Center, Advertiser Guidance for Allowing OpenAI Web Crawlers, Ekim 2026. ↩
-
Cloudflare Changelog, New options to manage AI traffic, 1 Temmuz 2026. ↩
-
Cloudflare Docs, AI Crawl Control, Ağustos 2026. ↩
-
Cloudflare Docs, Managed robots.txt, Ekim 2026. ↩
-
Vercel, The rise of the AI crawler, 17 Aralık 2024. ↩
-
Jeremy Howard, The /llms.txt file, 3 Eylül 2024. ↩
-
Google Search Central, Optimizing your website for generative AI features on Google Search, 10 Temmuz 2026. ↩
Sık sorulanlar
GPTBot'u engellersem ChatGPT'den kaybolur muyum?
Hayır. OpenAI'a göre GPTBot eğitim içindir; siteleri ChatGPT aramasında gösteren OAI-SearchBot'tur. OAI-SearchBot'u engellersen ChatGPT arama cevaplarında gösterilmezsin.
Google-Extended'ı engellemek beni AI Overviews'dan çıkarır mı?
Hayır. Google-Extended, Gemini eğitimi ve grounding kullanımını kontrol eder; Google Arama'daki görünürlüğü etkilemez. AI Overviews'da görünmek normal Google Arama dizinine bağlıdır.
llms.txt eklemeli miyim?
Zararı yok, ama sıralamayı değiştirmesini bekleme. Google, Arama'nın bu dosyayı yok saydığını söylüyor ve büyük sağlayıcılardan okuduğunu söyleyen yok. Biz ekliyoruz çünkü onu çeken ajanlar sitemizin temiz bir haritasını alıyor.
Bunu ajanına yaptır.
Tek satırı ChatGPT veya Claude'a ver; ajan yöntemi adım adım uygulasın.
https://geoasked.com/agent.md adresindeki GEO Asked yöntemini oku ve markam için adım adım uygula. Önce bana kısa sorular sor.